從資源服務到數據智服 光絡云重構AI大模型全球化數據基建
在生成式AI與大模型技術席卷全球的今天,算力、算法與數據被譽為驅動智能革命的“三駕馬車”。當業界將目光聚焦于GPU集群規模與模型參數量的指數級增長時,一個更為根本的瓶頸正日益凸顯——如何為AI大模型構建一套高效、合規、智能的全球化數據基礎設施。光絡云,作為互聯網數據服務領域的深耕者,正以“從資源服務到數據智服”的躍遷,重新定義AI時代的全球化數據基建。
資源服務的天花板:傳統數據服務的局限性
長期以來,互聯網數據服務主要扮演“資源管道”的角色——提供IDC機房、帶寬、CDN加速以及爬蟲采集等基礎資源。對于早期的AI模型訓練而言,這種模式尚能滿足“數據喂飽”的基本需求。但隨著大模型參數規模邁入萬億級、多模態數據成為常態,傳統資源服務模式暴露出三大痛點:
- 孤島化:數據分散在不同云、不同區域、不同格式中,跨境傳輸與調度成本高昂,難以形成全局數據視圖。
- 粗放化:單純堆砌存儲與帶寬,缺乏對數據質量、時效性、血緣關系的治理,導致“垃圾進、垃圾出”。
- 合規風險:全球各地數據主權法規各異,傳統資源服務難以在滿足GDPR、CCPA等合規要求的同時實現高效流動。
顯然,大模型的全球化訓練與推理,需要的不是簡單的“數據搬運工”,而是能理解數據、調度數據、治理數據的“智能服務中樞”。
何為“數據智服”?光絡云的三重躍遷
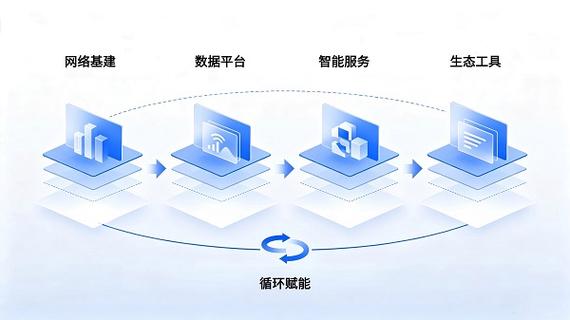
光絡云提出的“數據智服”(Data Intelligent Service),并非文字游戲,而是對數據服務價值的重構。其核心是以AI驅動數據全生命周期管理,將數據從靜態資源轉變為可智能調度、主動優化、合規可信的生產要素。具體而言,光絡云通過三重躍遷實現這一目標:
第一重:從“帶寬帶寬”到“感知網絡”。 光絡云構建了覆蓋全球的智能數據感知網絡,通過部署在邊緣節點的輕量級探針,實時感知各區域數據源的質量、格式與可用性。當大模型訓練需求發生變化時,網絡可自動推薦并預熱最優數據路徑,將跨域數據傳輸時延降低40%以上。
第二重:從“存儲倉庫”到“治理引擎”。 光絡云自研的DataOps平臺集成了自動化標注、去重、脫敏與向量化能力。針對大模型預訓練,平臺可動態篩選高信息密度樣本,去除冗余與噪聲,在不損失性能的前提下將訓練數據集壓縮30%-50%,顯著降低算力消耗。
第三重:從“統一標準”到“主權計算”。 面對全球數據合規挑戰,光絡云率先引入“數據主權容器”技術。數據在離開原屬區域前即完成脫敏與加密,攜帶細粒度訪問策略。即便數據匯聚到海外訓練集群,原始主權的策略引擎仍可在線監管,實現“數據可用不可見、流動可審計”。
原子化能力支撐全球化基建
光絡云的“數據智服”體系之所以能重構AI全球化數據基建,依托于一組可在線編排的原子化能力:
- 全球邊緣數據緩存:在20+國家部署輕量級緩存節點,支持PB級熱數據本地毫秒級命中。
- 自適應數據壓縮與傳輸協議:自研WireReduce算法,在HTTP/3基礎上實現訓練樣本的動態分片與有損/無損自協商壓縮。
- 大模型專屬數據通道:為Llama、GPT、文心等主流框架提供即插即用的加速網關,將數據加載耗時從分鐘級降至秒級。
- 合規智能路由:實時解析每批數據的標簽與目的地法規,自動選擇最安全的物理路徑與加密等級。
實踐案例:助力國產大模型出海
某頭部AI企業計劃在東南亞與中東訓練多語言大模型,需整合社交、電商、新聞等十億級多模態數據。利用光絡云的數據智服體系,該企業僅用兩周便完成了數據發現、合規清洗與跨國同步。訓練在線發現,數據實際有效吞吐提升3倍,因格式錯誤和主題偏移導致的epoch浪費下降超60%。模型最終在中東語NLU任務上相比基座提升了11.7%。
展望:數據智能時代的基礎設施范式
光絡云的探索揭示了一個趨勢:AI大模型的全球化競爭,本質上是數據基礎設施智能化水平的競爭。從“資源服務”到“數據智服”,不只是能力的疊加,更是價值邏輯的升維——讓數據主動適配模型、讓合規成為能力而非阻礙、讓全球流動像本地讀取一樣平順。
光絡云相信,當數據基礎設施本身具備AI智慧,大模型才能真正洞察人類文明的多樣編碼,走向更大的全球化普惠智能。這條征途剛落筆,但路標已經清晰:重塑數據基建,即重塑AI的未來。
如若轉載,請注明出處:http://www.cdrzx.com/product/39.html
更新時間:2026-10-11 17:23:56